Fórum témák
» Több friss téma |
Fórum » AI szerver házilag - olcsón?
A fórum tagjai között épített már valaki AI szervert házilag olcsón? Egyre többet hibáznak a "nagy" AI-k és már bevallom elég volt etetni őket. Annyiba kerül lassan, mint egy saját szerver.
Igazad van, és mégse!
Nagyon jól kell tudni promtolni! Meg kell neki mondani, mit csináljon és hogyan! És ami a legfontosabb, hogy mit NE csináljon! A feladatokat kisebb részre kell osztani, modulárisan felépíteni a feladatot, a modulokat külön csiszoltatni vele.
Nekem saját gépen megy, 20 magos proci 32Gddr5 ram 16G vga, ollama-t felteszed és kiválasztod melyik modelt szeretnéd használni és mehet a játék.
Meg a MacMinit is sokan használják erre, mert a vram ugyanaz mint a rendes, tehát jó sok, és "annyira nem drága". Akinek kell ugye..
Mire képes egy ilyen lokálisan futó AI szerver? Pl. tud-e magyarul megadott instrukciók alapján, bármilyen nyelvű weboldalakon információkat keresni - és megtalálni? Képes azoknak az információknak a kiszűrésére amelyek lefedik a kérdés lényegét?
Na ez engem is érdekelne. Illetve hogy mennyit fogyaszt.
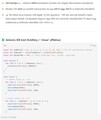
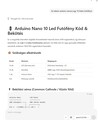
Szia! én offline használom, de ha kiengedem akkor azt is tudja használni, arduino programok írását, javítását offline megírja magyar utasítások alapján. Nem olyan gyors mint az online verziók de nekem elég.
Kb így csinálja.
Úgy látom hwben sem kell túlságosan rá hallgatni. Az a 330ohm a 100 éves halovány ledekhez passzolt, a mai ledekhez inkáb kohm nagyságrend stimmel.
Pedig figyelem a témát, igaz csendben.
 Sajnos a RAM és videókártya árak nagyon elszálltak, sőt az SSD árak is. Nekem 24GB RAM (nem mai, DDR3...) és egy 2GB-os GTX 750Ti (ez se mai) kártyám van. A RAM még talán elég lenne valamire, de a kártya gondolom semmire. Másikat meg nem akarok venni, szóval egyelőre csak csendes megfigyelő vagyok.
ha nem csak annyit mondasz neki hogy találjon ki magától valamit, akkor amit megadsz lp milyen leded van, már is azzal kalkulál..
Akkor régebbi kripto bányász gépet érdemes lenne AI-ra venni?
AI ágensekSziasztok!Valaki "tart" otthon MI ügynököket? helyesebben fogalmazva: Használ ügynök-keretrendszert valaki? Tapasztalatok? Gondolatok?
Abszolút. Egy ismerősöm pontosan ezt tette.
Úgy tűnik promptolhatom ahogy akarom, egyre inkább a feladatkerülés és tokenzabálás a funkció 99%-a. Így gyorsan lefogy a Pro, a maradék tudás meg már csak hülyeségeket válaszol hatalmas terjedelemben. ChatGPT, Google Gemini egykutya.

Gyanítom, sima egyszerű "chatbot"-tal nem nyerhetsz csatát!
https://share.google/aimode/v50OAJv9AZHHQf7ZZ https://share.google/aimode/QM5aPeAmaWJPxKQ9f De egyébként értem a problémát! Én is még ott tartok, hogy tanulom, finomítom!. Tegnap este az egész összedőlt, valamit nagyon elbaltáztam!
ÖsszefoglalóMost, hogy lett némi rálátásom a témára, írnék pár sort!AI szerver: Alapjából az AI alatt magát az "agyat" az LLM-et értenénk! Ennek helyi futtatásához Ollama (vagy valamelyik testvére) szükséges, és egy kiválasztott (ingyenes ?megvásárolt?) modell, a szoftver oldalon. Hardver oldalon viszont brutális videokártya, vagy kártyák, hogy egyáltalán élhető sebességgel működjön!! Ez költségben milliós tétel.. persze lehet futtatni olcsób hardveren is, de azt minek?? Jelen állás szerint rengeteg, még használható, ingyenes modell érhető el különböző szolgáltatónál, mint pl az Openrouter! Helyileg futtatott LLM csak akkor éri meg ha igazán érzékeny adatokkal akarunk vele dolgozni, nem kerülhet ki a netre. Kis kitérő! A használt LLM "minősége" NAGYBAN befolyásolja a felhasználói élményt! Vannak általános, és speciális használatra kihegyezet LLM modellek! Mindegyiket használjuk amire való, egyébként kudarc lesz az eredmény!! Ne feledjük az AI (LLM) nem gondolkozik nem ért, csak a tanult minták alapján a legvalószínűbb eredményt adja vissza! Másik biztosan hallot szó: az AI ügynökök! (ágensek) Olyan programok, akik a hozzájuk kapcsolt LLM-mel feladatokat tud végrefajtani, akár autonóm módon! Ilyen ügynököt, vagy ügynök keretrendszert már könnyedén (értsd ezalatt, kifizethető áron) tudunk otthon, számítógépen, "szerveren" futtatni! Itt se várjunk csodát már az első nap! Nem egy varázsszer, és mivel a legtöbb ember nem ért hozzá (én se) lesznek keserű percek! Nehéz olyan ügynök szervezet építeni, ami egy feladatot, lépésenként úgy végigvisz, hogy közben minden problémát megold, több szemszögből, megvízsgál! Nekünk emberenkek ez könnyü, egy ügynök csak akkor vált nézőpontot, ha ezt meghatározzuk neki!! Egy kezdő ügynökcsapat kb. mint egy páréves gyerek, tanítani kell, sokat! És addig hibázni fog! Remélem meglátom mihamarad azt mikor már valóban dolgozik! A hozzászólás módosítva: Okt 1, 2026
Idézet: „Ne feledjük az AI (LLM) nem gondolkozik nem ért, csak a tanult minták alapján a legvalószínűbb eredményt adja vissza!” Ezt a mondatot el kellene felejteni, egy csomó helyen láttam már, de szerintem egy hozzánemértő totális félreértéséből írhatta le, és utána mindenhol ezt mantrázzák. Ez miatt én évekig kerültem az AI használatát (úgy érzem messze van az érdeklődési köröm a "legvalószínűbbtől"), kb. annyira használtam amennyire megkerülhetetlenné tették a keresőmotorok (mint látjuk egyre inkább ezzel generált összesítőket tolják az arcunkba). Most, hogy az OpenAI-nak volt egy egyhónapos próbaidôszaka, én elkezdtem kipróbálni, először csak böngészőben (írattam vele két kis GUI alkalmazást, azaz a forráskódját, és én lefordítottam a saját fejlesztôkörnyezetemben, munkámat segítendő, a végleges programokat tizenpár iterációból összehozta, persze nyilván le tudtam írni mit akarok pontosan, mivel három évtizede programozok, amúgy minimálisan kellett csak belenyúlnom a kész programokba). Majd pár hét kihagyás után, feltettem a Codex alkalmazást (ez a ChatGPT sajátja), ami egy programozást segítő AI ügynök. Döbbenetes az a gyorsaság amivel meg tudja tolni az ember munkáját, egy heti munkát néhány órásra rövidít, és olyan logikai összefüggésekre mutat rá, mi több meg is old illetve kiegészíti a kódot kérésem nélkül oda való dolgokkal, hogy csak nézek. És amikor rákérdezek hogy ezt meg azt miért csinálta (mert látom hogy nagyon jól csinálja, de én nem kértem erre), akkor nagyon alaposan leírja, és igazi is van. És ez nagyon nem egy "legvalószínűbb eredmény" hanem konkrét átgondolt logika (én magamtól trial & error jutottam volna el ugyanide néhány órával később, de az AI előre gondolt rá). Mivel sosem botlottam hasonló programrészekbe ebben a nyelvben (pedig van hogy egy napot elvacakolok ilyesmi keresésével GitHubon, hátha nem nulláról kell kikaparnom a gesztenyét, persze többnyire feleslegesen), ezért ez nem egy "a sok tanulás átlaga", hanem jóval több annál. Igenis gondolkozik.
Idézet: „Ezt a mondatot el kellene felejteni, egy csomó helyen láttam már, de szerintem egy hozzánemértő totális félreértéséből írhatta le, és utána mindenhol ezt mantrázzák.” Pedig igaz, és az is marad! Rengeteg finomitás, paraméterezés miatt tűnik annak, hogy mégse egy "szimpla statisztikai" program! https://share.google/aimode/QL1pq2QvwCbMyuaTG De azon területen ahol ezt még nem finomították ki, tanították meg neki, akkora baromságot csinál, hogy az ember lefordul a székről!! Ezért is mondtam a megfelelő modellt, a megfelelő feladatra!! Programozásra már én is elég régóta használom, ez a terület nagyon látványosan fejlődött az elmúlt 1 évben. Most találtam gépészeti (alkatrész) tervező AI programot, az is félelmetes sebességgel megoldotta a problémát! Most van egy ügynök csapatom aminek egy elektronikai feladatot dobtam be. Nem megoldhatatlan számomra sem, így könnyebben tudom a munkájukat bírálni. Itt azért már voltak bődületes hülyeségek! Majd látjuk, egyenlőre olyanok mint a 10 éves gyerek, nagy önbizalommal futnak neki a kérdésnek, mert még azt se látják, hogy hülyék hozzá!! Ez remélem fejlődik, majd oktatom őket!
Pedig de, az AI nem más, mint egy elképzelhetetlenül optimalizált szöveg prediktor. Persze sok féle toolt meg mindent futtat már, de a válasz szöveg egy valószínűségi számítás eredménye. Ha megkérdezed az AI-t erről (hogy generálja a programkódot), ezt írja:
Idézet: „Egy LLM (például én) lényegében tokenenként becsüli meg, hogy az eddigi kontextus alapján melyik következő token a legvalószínűbb.”
Ezt meg tudom erősíteni ezzel a (már 6 hónapos) példával, ahol Andreas Spiess (a svájci akcentusos csávó
 ) Claude AI-jal, ügynökökkel, ~3 óra alatt Github-ra implementáltatott ESP32-re nemcsak egy működő, ~3000 (3ezer) soros projektet, de megíratta a leírását, teljes dokumentumát, rátöltette ESP32 hardverre, leteszteltette. Tanulságos, ember legyen a talpán, aki megérti..... De a végeredmény lenyűgöző.
Pont ezt írtam, hogy a tájékozatlanság hibás és káros mantrákat szül.
Feltettem a kérdést: Sok helyen írják, hogy tokenenként becsülöd meg mi a következő legvalószínűbb válasz, amit egy kérdezz-felelek esetén megértek, de problémás komplex kód esetén nem egy válasz van, hanem hibakeresés, erre hogyan lehet LLM-et tréningezni? Idézet: „Igen — és itt van az a pont, ahol a „következő tokent jósolja” leírás technikailag igaz, de félrevezetően leegyszerűsítő. Egy LLM valóban tokenenként állítja elő a kimenetet. De a tréning során ahhoz, hogy jól tudja megjósolni a következő tokent, kénytelen megtanulni rengeteg belső összefüggést és reprezentációt. Emiatt képes olyan feladatokra is, mint a hibakeresés, ahol a helyes folytatás megtalálásához előbb következtetni kell.” És 7 oldalon át példákkal illusztrálja miként tanulta ezt meg... Idézet: „És éppen ezért félrevezető az interneten gyakori mondat, hogy „az LLM csak megjósolja a következő szót”. A „csak” a problémás része. Olyan ez, mintha azt mondanánk, hogy egy processzor „csak tranzisztorokat kapcsolgat”. Igaz — de ebből nagyon kevés derül ki arról, hogy a tranzisztorok kapcsolgatásával milyen magasabb szintű számítást képes megvalósítani.” A következtetés pedig logikai gondolkodás, tényből vagy bizonyítékból egy új megállapítást vonunk le.
Idézet: „tájékozatlanság hibás és káros mantrákat szül.” Tudod mi szül káros dolgokat?? Ha az AI egy egyszerű email olvasásból, amit már többször hibálanul teljesített, egy kitalált, "behazudott" hallucinált hibával tér vissza! A nyomozás kiderítette, hogy ez egy ismert probléma, 40% környéki tényezővel előfordulhat, fejlesztők is foglalkoznak vele. Egy beállítás módosításával ez 0,8% környékére csökkenthető! Szerintem a 0,8% is nagyon sok.... Szóval az megy neki amire megtanították!!
Az emberek is gyerekkortól tanulnak. A sebességek a különbség - a tanulás és gondolkodás, variációk átnézése, kipróbálása. Ne feledjük: az AI is egy szerszám, ami sokféleképpen használható.
A kvantumszámítógép ott kezdődik, ahol a mai AI véget ér: a szinte végtelen számú lehetőségek régóta megoldhatatlan problémáin. Viszont a kvantumszámítógép programozásánál-optimalizálásánál megint kikerülhetetlen az AI. Lásd például: sakk, go, bűvös kocka (mikrovezérlő programírás). Csupán néhány egyszerű szabály van, mégis szinte végtelen variáció, stratégia lehet (bűvös kockánál: 43 252 003 274 489 856 000 ~ 43 trillió). Fontos ez emberi intuíció, hiszen ember nem látja át - mégis egy ~6 éves kínai lány tartja a kirakás világcsúcsát ~5 másodperccel. A gépi kirakás rekordja tizedmásodpercnyi. Ma már az AI megveri ezekben az emberi világbajnokokat. A hozzászólás módosítva: Hé, 7:45
Jó 2 éve kezdtem beleásni magam, akkor egy 1Gb-os AMD videokártyám volt. A gépben 32Gb Ram. Gyakorlatilag mindent sikerült futtatnom korlátokkal és nagyon lassan - mivel Amd támogatás igazából nincs, az NVidia szoftvereivel lehet kihasználni a Gpu igazi teljesítményét. Mert hiába volt nekem 32 a Ram, siralmasan lassú a Cpu a Gpu teljesítményéhez képest!!! Szóval nyugodtan próbáld ki a 2Gb Nvidia kártyádat, mert azzal már működik a rendszer, tudsz tanulni, gyakorolni. Persze korlátok között, de azok is tanulandó fogalmak... (Fél év után vettem jobbat
 ) Értem ezalatt, hogy ha jobb minőségű modelt használsz, akár perceket is kell várni még egy egyszerűbb utasításra (prompt) is. A gyengébb model-ek pedig kisebb tudáshalmazzal rendelkeznek, a válaszok minősége is gyengébb. Ezeket számokkal jelzik a model nevében: 4B, 8B, 16B, stb. Így a 16B model nemcsak 4X több biliárd tokennel van tanítva, mint a 4B, hanem saját "tanulása" miatt még sokkal okosabb - de az sok GRam-ot igényel. A 4B, 5B vagy quantált model-ek meg "kényelmesen" elfutnak egy 2Gb GRam alatt is - persze a válaszok milyensége rovására. Igaz, én LLM-t (helyi model - nevezhető lokális chat modelnek talán) nem kezdtem el használni, mert az ingyenesen letölthető model-ek összehasonlíthatatlanul lassúak s buták a felhő alapú chat-ekehez képest. (Igaz, már 8Gb Nvidia kártyám van, de az is korlátok közé szorít) Én azok közt is kizárólag ingyeneseket használok. Szóval a válaszok minősége és sebessége a Model minőségétől függ, az pedig attól, mennyi GRam van a gépben. Engem egyébként inkább a képek generálása hoz lázba, így nem is erőltettem az LLM vonalat. Azon a területen iszonyat fejlesztések mennek, pl rengeteg model-t optimalizálnak, hogy már 2G vagy 4G VRam-on is fussanak. Idézet: „a legvalószínűbb eredményt adja vissza!” Látom, ez némi vitát szül. A Model tanítása során már meglévő kész eredményeket használnak (jókat és hibásakat is - a hibák okaival együtt - mindegy, ez mély téma), és persze van egy Tanár is, aki betanítja a model-t. Így a model a tanár stílusát is megtanulja, követi azon logikai módszerét elsősorban - mindazonáltal rengeteg online információhoz hozzáfér. Tehát nem csak valószínűségszámítást végez, hanem felhasználja a tapasztalatokat, a "Solved" /megoldott problémákat. Ahogyan Ti felhasználjátok ezt a Fórumot eszmecserére, tapasztalatok kérdésére...  Tehát a válasz függ a Model-től - így attól a 'cégtől', aki betanította; a betanított tokenek mennyiségétől; a 'tanártól' is; hogy szakosodott tanítást kapott-e vagy általánosat; hogy mennyire fér hozzá az online infókhoz, és még sorolhatnám....
Na igen, azt látom, hogy DIY lokális AI szerver inkább tanulásra, skill szerzésre jó, semmint használni. Azóta nem foglalkoztam vele időhiány miatt. Ami esetleg engem érdekelne, az az objektum felismerés kép (video) alapján. Látok már olyan videókat a neten, ahol egy ESP32-vel tudnak objektum detektálást csinálni (lokálisan). Sőt itt a fórumon már csináltak is hasonlót.
Bár még nem tudom mire tudnám használni, de elég menő, hogy ide eljutottunk. |
Bejelentkezés
Hirdetés |